ความเห็นส่วนตัวต่อโครงการ TH-AI Passport (AiPASS)
-
 Theethawat Savastham
- 05 Sep, 2026
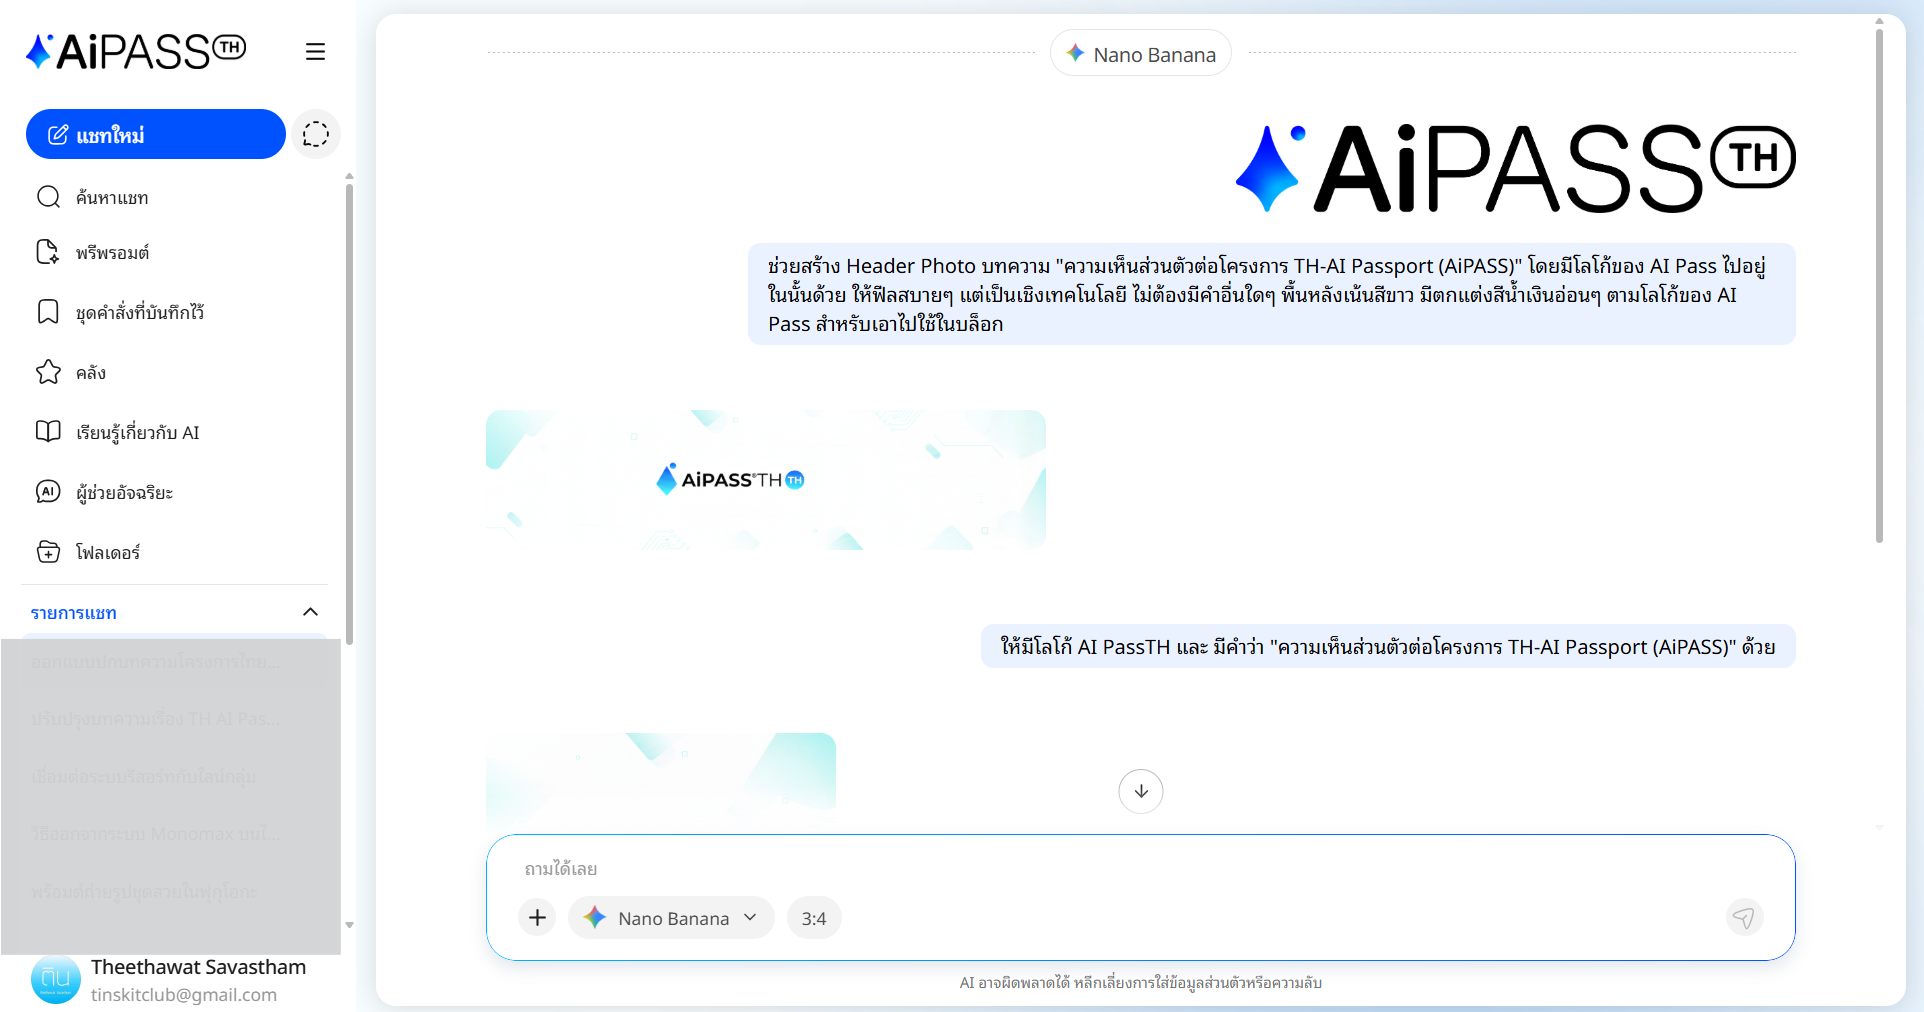
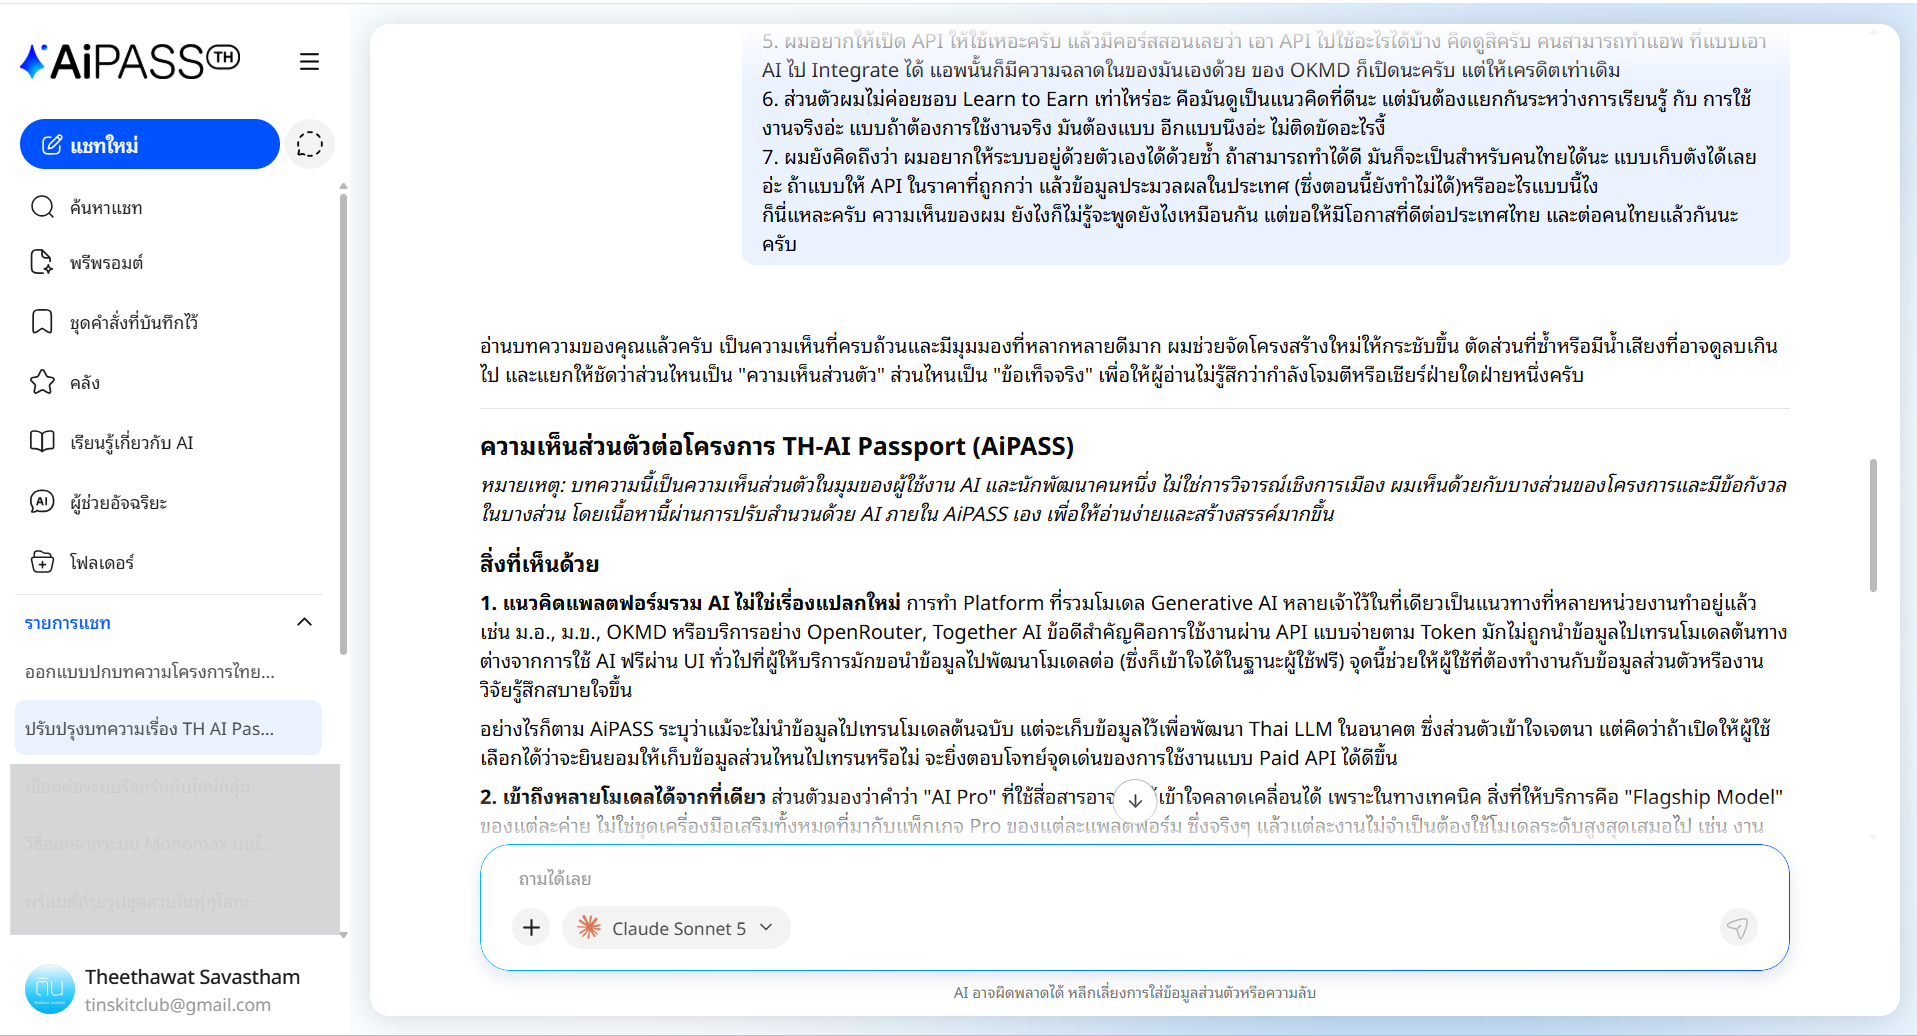
บทความนี้เป็นความเห็นส่วนตัวในมุมของผู้ใช้งาน AI และนักพัฒนาคนหนึ่ง ไม่ใช่การวิจารณ์เชิงการเมือง ผมเห็นด้วยกับบางส่วนของโครงการและมีข้อกังวลในบางส่วน โดยเนื้อหานี้ผ่านการปรับสำนวนด้วย AI ภายใน AiPASS เอง (Claude Sonnet 5) เพื่อให้อ่านง่ายและสร้างสรรค์มากขึ้น
สิ่งที่เห็นด้วย
- แนวคิดแพลตฟอร์มรวม AI ไม่ใช่เรื่องแปลกใหม่ การทำ Platform ที่รวมโมเดล Generative AI หลายเจ้าไว้ในที่เดียวเป็นแนวทางที่หลายหน่วยงานทำอยู่แล้ว เช่น ม.อ., ม.ข., OKMD หรือบริการอย่าง OpenRouter, Together AI ข้อดีสำคัญคือการใช้งานผ่าน API แบบจ่ายตาม Token มักไม่ถูกนำข้อมูลไปเทรนโมเดลต้นทาง ต่างจากการใช้ AI ฟรีผ่าน UI ทั่วไปที่ผู้ให้บริการมักขอนำข้อมูลไปพัฒนาโมเดลต่อ (ซึ่งก็เข้าใจได้ในฐานะผู้ใช้ฟรี) จุดนี้ช่วยให้ผู้ใช้ที่ต้องทำงานกับข้อมูลส่วนตัวหรืองานวิจัยรู้สึกสบายใจขึ้น
อย่างไรก็ตาม AiPASS ระบุว่าแม้จะไม่นำข้อมูลไปเทรนโมเดลต้นฉบับ แต่จะเก็บข้อมูลไว้เพื่อพัฒนา Thai LLM ในอนาคต ซึ่งส่วนตัวเข้าใจเจตนา แต่คิดว่าถ้าเปิดให้ผู้ใช้เลือกได้ว่าจะยินยอมให้เก็บข้อมูลส่วนไหนไปเทรนหรือไม่ จะยิ่งตอบโจทย์จุดเด่นของการใช้งานแบบ Paid API ได้ดีขึ้น
-
เข้าถึงหลายโมเดลได้จากที่เดียว ส่วนตัวมองว่าคำว่า “AI Pro” ที่ใช้สื่อสารอาจทำให้เข้าใจคลาดเคลื่อนได้ เพราะในทางเทคนิค สิ่งที่ให้บริการคือ “Flagship Model” ของแต่ละค่าย ไม่ใช่ชุดเครื่องมือเสริมทั้งหมดที่มากับแพ็กเกจ Pro ของแต่ละแพลตฟอร์ม ซึ่งจริงๆ แล้วแต่ละงานไม่จำเป็นต้องใช้โมเดลระดับสูงสุดเสมอไป เช่น งานถามตอบทั่วไปอาจไม่ต้องใช้ Claude Opus แต่งานที่ต้องการคำอธิบายเป็นธรรมชาติอาจเหมาะกับ Gemini/Gemma งานตอบตรงเหมาะกับ ChatGPT งานออกแบบเหมาะกับ Claude เป็นต้น (นี่คือความชอบส่วนตัว ผู้ใช้แต่ละคนอาจมีความเหมาะสมกับงานต่างกันไป)
-
โอกาสสำหรับโมเดล Open Source และโมเดลไทย ปัจจุบันมีโมเดล Open Weight คุณภาพดีจำนวนมาก รวมถึงโมเดลไทยอย่าง Typhoon (SCB10x) แต่ส่วนใหญ่ยังจำกัดอยู่ในรูปแบบ Playground หรือต้องดาวน์โหลดมาใช้เอง ซึ่งใช้ทรัพยากรคอมพิวเตอร์สูงและเหมาะกับนักพัฒนามากกว่าผู้ใช้ทั่วไป ปัจจุบัน AiPASS มีเพียง Pathumma LLM (NECTEC) เป็นโมเดลไทยหลัก ซึ่งผมมองว่าน่าจะเป็นโอกาสดีที่จะเปิดพื้นที่ให้โมเดลไทยอื่นๆ ได้แสดงศักยภาพเพิ่มเติม
ข้อกังวลและมุมมองที่ต่าง
การรวมทุกอย่างไว้ในแพลตฟอร์มเดียว นี่เป็นความเห็นส่วนตัวที่ค่อนข้างเอนเอียงไปทางมุมมองนักพัฒนา บางคนอาจมองว่าการทุ่มงบให้กับโมเดลเดียวแบบเต็มรูปแบบจะให้ประสิทธิภาพสูงกว่าการกระจายไปหลายโมเดล ซึ่งเป็นข้อถกเถียงที่ไม่มีคำตอบตายตัว
การพึ่งพา AI แบบแชทบอทเป็นหลัก ส่วนตัวคิดว่าการส่งเสริมทักษะเฉพาะทาง เช่น การใช้ Canva AI ในงานออกแบบ, AI Agent สำหรับโค้ดดิ้ง (GitHub Copilot, Claude Code, Codex) หรือ Gemini Notebook/NotebookLM สำหรับงานวิจัย อาจสร้างทักษะที่นำไปใช้ต่อยอดได้จริงมากกว่าการใช้แชทบอทเพื่อสร้างงานสำเร็จรูปทั้งหมด เช่น ให้ AI สร้างโปสเตอร์หรือโค้ดทั้งชิ้นแล้วนำไปใช้ทันที เพราะบริษัทเทคเหล่านี้มักมีส่วนลดหรือแคมเปญฟรีสำหรับนักศึกษาอยู่แล้ว การสนับสนุนแบบเจาะจงเครื่องมืออาจช่วยพัฒนาทักษะเฉพาะทางได้ดีกว่า
ข้อเสนอแนะเพื่อการพัฒนา
- ระบบเลือกโมเดลอัตโนมัติ (Smart Routing): เพิ่มชั้น AI สำหรับวิเคราะห์คำถามและเลือกโมเดลที่เหมาะสมโดยอัตโนมัติ แทนที่จะให้ผู้ใช้เลือกเอง วิธีนี้ช่วยประหยัดต้นทุน Token โดยงานง่ายส่งให้โมเดล Open Weight งานวิเคราะห์ซับซ้อนส่งให้โมเดลระดับสูง แม้จะมี Latency เพิ่มขึ้นบ้าง แต่คุ้มค่ากับการควบคุมต้นทุนในระยะยาว (แนวทางนี้สอดคล้องกับที่เกาหลีใต้พยายามลดการพึ่งพาโมเดล Closed Weight เช่นกัน)
- โหมดตรวจจับบริบทการเรียนรู้: หากระบบพบสัญญาณว่าผู้ใช้เป็นนักเรียนที่กำลังถามการบ้าน ควรสลับไปโหมด Guided Learning โดยอัตโนมัติ เพื่อป้องกันการใช้ AI ทำการบ้านแทนการเรียนรู้
- โหมดความเป็นส่วนตัวขั้นสูง (Private Mode): เปิดตัวเลือกให้ผู้ใช้ยืนยันได้ว่าข้อมูลจะไม่ถูกนำไปเทรน Thai LLM หรือเก็บไว้เกินความจำเป็น พร้อมการเข้ารหัสและลบข้อมูลอัตโนมัติภายในระยะเวลาที่กำหนด ซึ่งจะตอบโจทย์การใช้งานข้อมูล Sensitive เช่น งานวิจัยหรือข้อมูลราชการได้ดีกว่าบริการฟรีทั่วไป
- ทบทวนโมเดลเริ่มต้น (Default Model): ควรพิจารณาความคุ้มค่าระหว่างราคากับคุณภาพคำตอบของโมเดลเริ่มต้นให้รอบคอบ เนื่องจากราคา API ของผู้ให้บริการเปลี่ยนแปลงบ่อยและมีหลายเวอร์ชัน แนะนำให้ตรวจสอบราคาล่าสุดก่อนตัดสินใจ และอาจพิจารณาโมเดล Open Weight บางตัวเป็นทางเลือกเพิ่มเติม เนื่องจากภาครัฐมักได้ราคาต่อรองที่ต่ำกว่าราคาขายปลีกทั่วไปอยู่แล้ว
- เปิด API ให้นักพัฒนาใช้งานพร้อมคอร์สอบรม: เพื่อให้คนไทยสามารถนำ AI ไปต่อยอดสร้างแอปพลิเคชันของตัวเองได้ (คล้ายกับที่ OKMD เปิดให้ใช้อยู่แล้ว) ซึ่งจะสร้างมูลค่าเพิ่มในวงกว้างกว่าการใช้งานผ่านหน้าเว็บเพียงอย่างเดียว
- แยกกลไก Learn to Earn ออกจากการใช้งานจริง: ระบบให้รางวัลจากการเรียนรู้เป็นแนวคิดที่ดี แต่ควรแยกออกจากโควตาการใช้งานจริง เพื่อไม่ให้เกิดข้อจำกัดในการทำงานจริง
- เป้าหมายระยะยาว - ระบบที่พึ่งพาตนเองได้: หากในอนาคตสามารถพัฒนาให้มีการประมวลผลข้อมูลภายในประเทศ และเปิด API ในราคาที่แข่งขันได้ อาจกลายเป็นโครงสร้างพื้นฐาน AI ของไทยที่ยั่งยืนในระยะยาว (แม้ปัจจุบันยังทำไม่ได้)
สรุป
โครงการนี้มีทั้งจุดแข็งและจุดที่ควรพัฒนาต่อ ในฐานะเพื่อนร่วมวงการที่เข้าใจความเหนื่อยยากของทีมพัฒนา ผมหวังว่าข้อเสนอแนะเหล่านี้จะเป็นประโยชน์ต่อการปรับปรุงโครงการให้ตอบโจทย์ทั้งผู้ใช้งานทั่วไปและวงการเทคโนโลยีไทยในระยะยาว